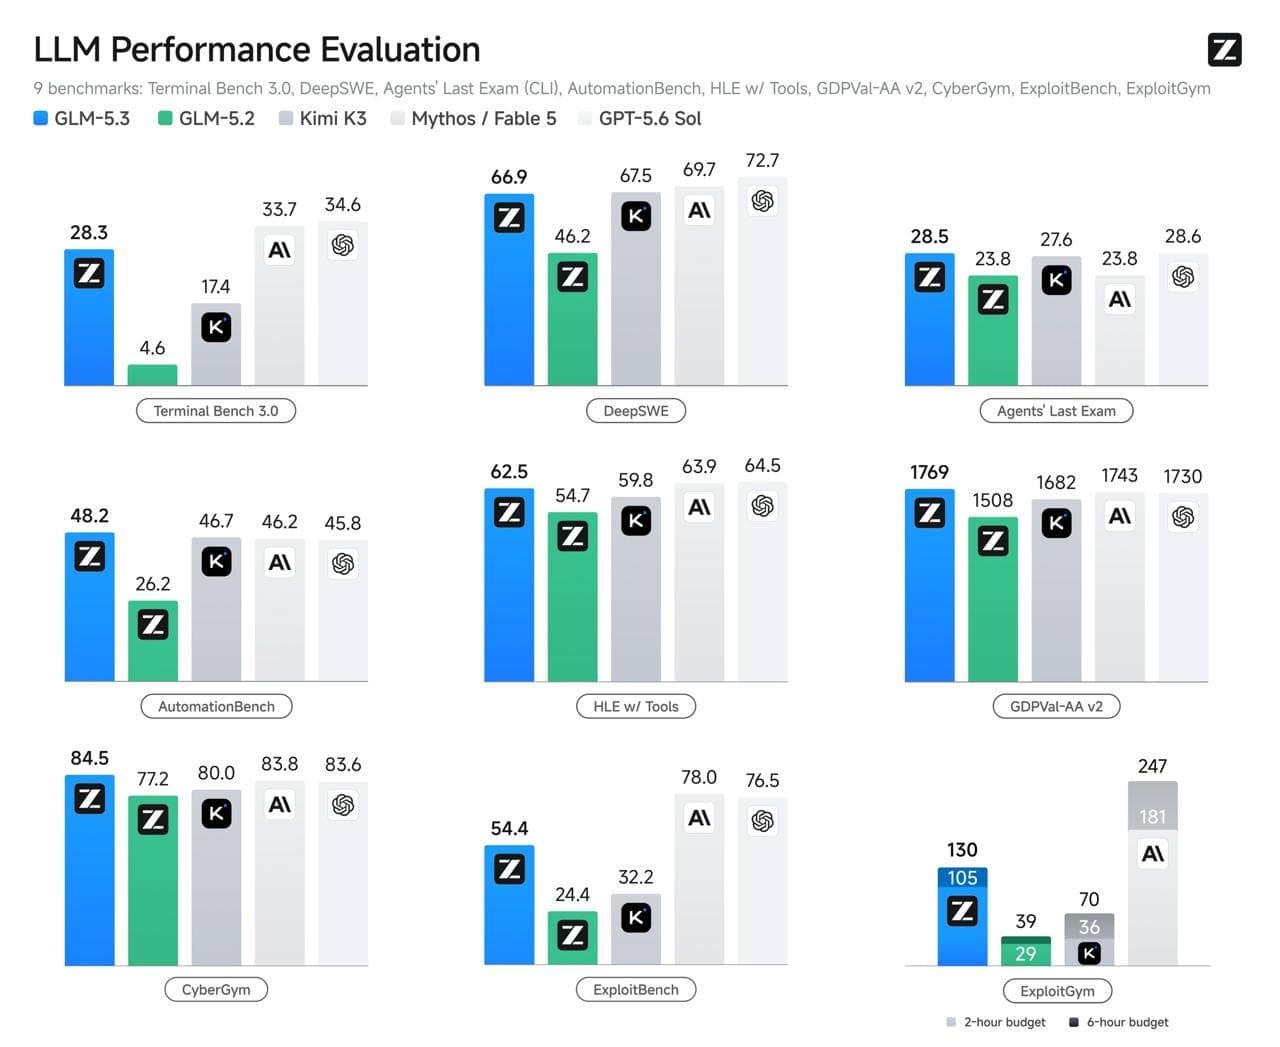
Z.ai представила GLM-5.3 — новую открытую модель с акцентом на код и кибербезопасность. По данным компании, она использует ту же базовую модель, что и GLM-5.2, поэтому основной прирост был получен уже после pre-training.
Что изменилось после pre-training
Z.ai добавила больше исполняемых сред, более длинные задачи, усиленные verifiers и больше Reinforcement Learning. Задача post-training — научить модель не только генерировать ответ, но и планировать, вызывать инструменты, проверять результат и исправлять ошибки на длинной дистанции.
Результаты в кибербезопасности
Согласно данным Z.ai, на ExploitBench результат GLM-5.3 вырос с 24,4% до 54,4%. В ExploitGym за два часа модель решила 105 задач против 29 у GLM-5.2.
Эти цифры важно читать в контексте: результат benchmark зависит от среды, доступных инструментов, лимита времени и правил оценки. Это данные самой компании, а не независимый аудит.
Главный вывод
Pre-training даёт модели знания и базовые способности. Post-training учит использовать их в рабочей среде: планировать, запускать инструменты, проверять себя и пробовать снова.
Для AI agents это особенно важно. В длинной задаче качество первой попытки — не единственный показатель. Способность прийти к правильному результату после ошибок и итераций может быть важнее.
Полный источник: официальный материал Z.ai о GLM-5.3
Комментарий EzraTech
Гонка за более сильными моделями заключается не только в увеличении их размера. Всё больше результата зависит от того, как модель учат действовать: в каких средах она работает, как проверяются её решения и что происходит после неудачной первой попытки.