חברת Z.ai פרסמה את GLM-5.3, מודל פתוח חדש שמתמקד בקוד ובסייבר. לפי החברה, המודל מבוסס על אותה משפחת בסיס כמו GLM-5.2, ולכן רוב השיפור הגיע דווקא בשלב ה-post-training.
מה השתנה אחרי ה-pre-training?
Z.ai הרחיבה את מספר סביבות הביצוע, האריכה את המשימות, שיפרה את ה-verifiers והגדילה את השימוש ב-Reinforcement Learning. המטרה היא לא רק לייצר תשובה, אלא לאפשר למודל לתכנן, להשתמש בכלים, לבדוק את התוצאה ולתקן טעויות לאורך זמן.
הפער בתחום הסייבר
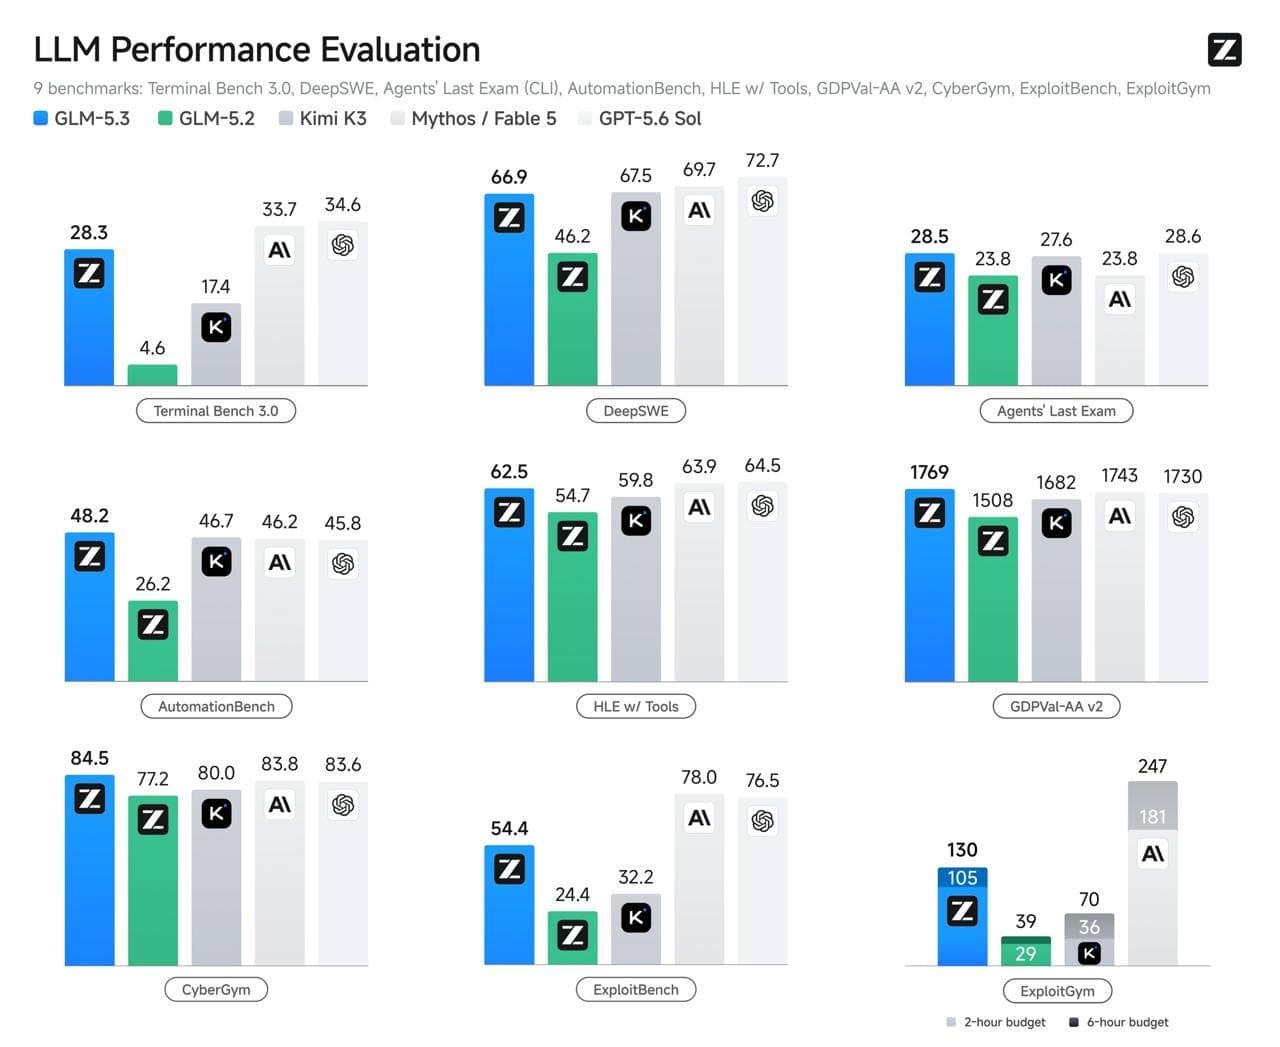
לפי תוצאות שפרסמה Z.ai, ב-ExploitBench הציון עלה מ-24.4% ב-GLM-5.2 ל-54.4% ב-GLM-5.3. ב-ExploitGym, במהלך של שעתיים, GLM-5.3 פתרה 105 משימות לעומת 29 במשימה המקבילה עם GLM-5.2.
חשוב לקרוא את המספרים בהקשר: תוצאות benchmark תלויות בסביבה, בכלים, בתקציב הזמן ובכללי ההערכה. אלה נתוני החברה, ולא בדיקה עצמאית.
המשמעות הרחבה יותר
Pre-training נותן למודל ידע ויכולת בסיסית. Post-training מלמד אותו להשתמש בהם בסביבה אמיתית: לתכנן, להריץ כלים, לבדוק את עצמו ולנסות שוב.
זהו כיוון חשוב עבור AI agents. במערכת שמבצעת משימות ארוכות, איכות התשובה הראשונה אינה המדד היחיד. היכולת להגיע לתוצאה לאחר טעויות ותיקונים עשויה להיות חשובה יותר.
למקור ולנתונים המלאים: הפוסט הרשמי של Z.ai על GLM-5.3
הזווית של EzraTech
המירוץ למודלים חזקים לא עובר רק דרך מודל גדול יותר. יותר ויותר מהתוצאה נקבעת לפי האופן שבו המודל מתאמן לפעול: באילו סביבות הוא עובד, איך בודקים אותו, ומה קורה כשהניסיון הראשון נכשל.