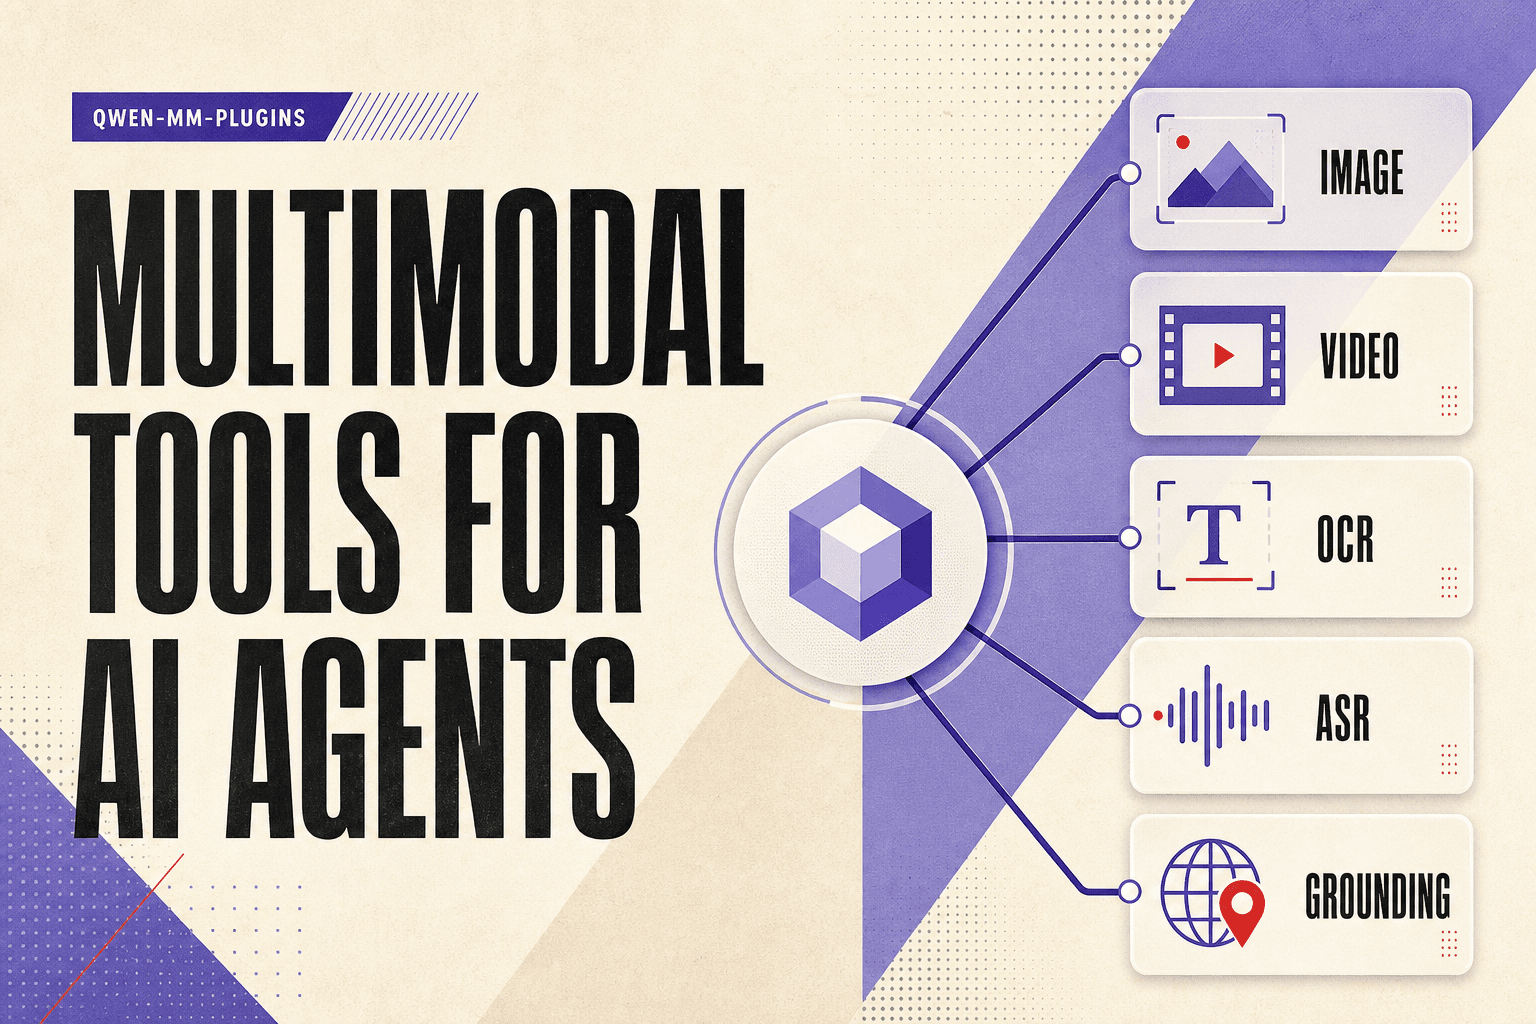
Qwen опубликовала Qwen-MM-Plugins — open source-проект с модульным подходом к мультимодальным возможностям AI-агентов.
Вместо того чтобы подключать агента к одной мультимодальной модели, которая должна выполнять все задачи, проект выносит отдельные capabilities в слой инструментов. Агент может обнаружить нужный инструмент и вызвать его в подходящий момент.
Что входит в слой инструментов
Базовый capability включает чтение изображений, видео, документов и 3D-моделей, а также OCR, object grounding, segmentation, транскрибацию аудио и vision chat. Отдельные capabilities добавляют память для длинных видео, редактирование и генерацию видео, а также интеграции с Blender и FreeCAD.
Каждая capability устанавливается отдельно. В неё входит skill, который объясняет агенту доступный набор инструментов, и, если это необходимо, MCP-сервер, предоставляющий сами инструменты.
Как выглядит такой workflow
Агент может прочитать изображение, найти объект, вырезать нужную область, запустить OCR, сопоставить результат с кадром видео, транскрибировать аудио и собрать все найденные данные в один ответ.
Важен сам архитектурный сдвиг: мультимодальность становится набором подключаемых возможностей, которые можно заменять, расширять и соединять внутри agent harness. В документации проекта упоминаются Claude Code, Codex, Qwen Code и Gemini CLI.
Сложность перемещается на уровень orchestration
Модульность сама по себе не решает проблему надёжности. Агенту всё ещё нужно выбрать правильный инструмент, проверить результат, управлять разрешениями и понимать, когда следует остановиться, а не продолжать работу автоматически.
Практический вопрос теперь звучит иначе: не “какая модель умеет всё?”, а “какие инструменты агент умеет безопасно выбирать, запускать и объединять?”
Список capabilities и инструкции доступны в официальном репозитории на GitHub.