Локальная модель для длинных workflow
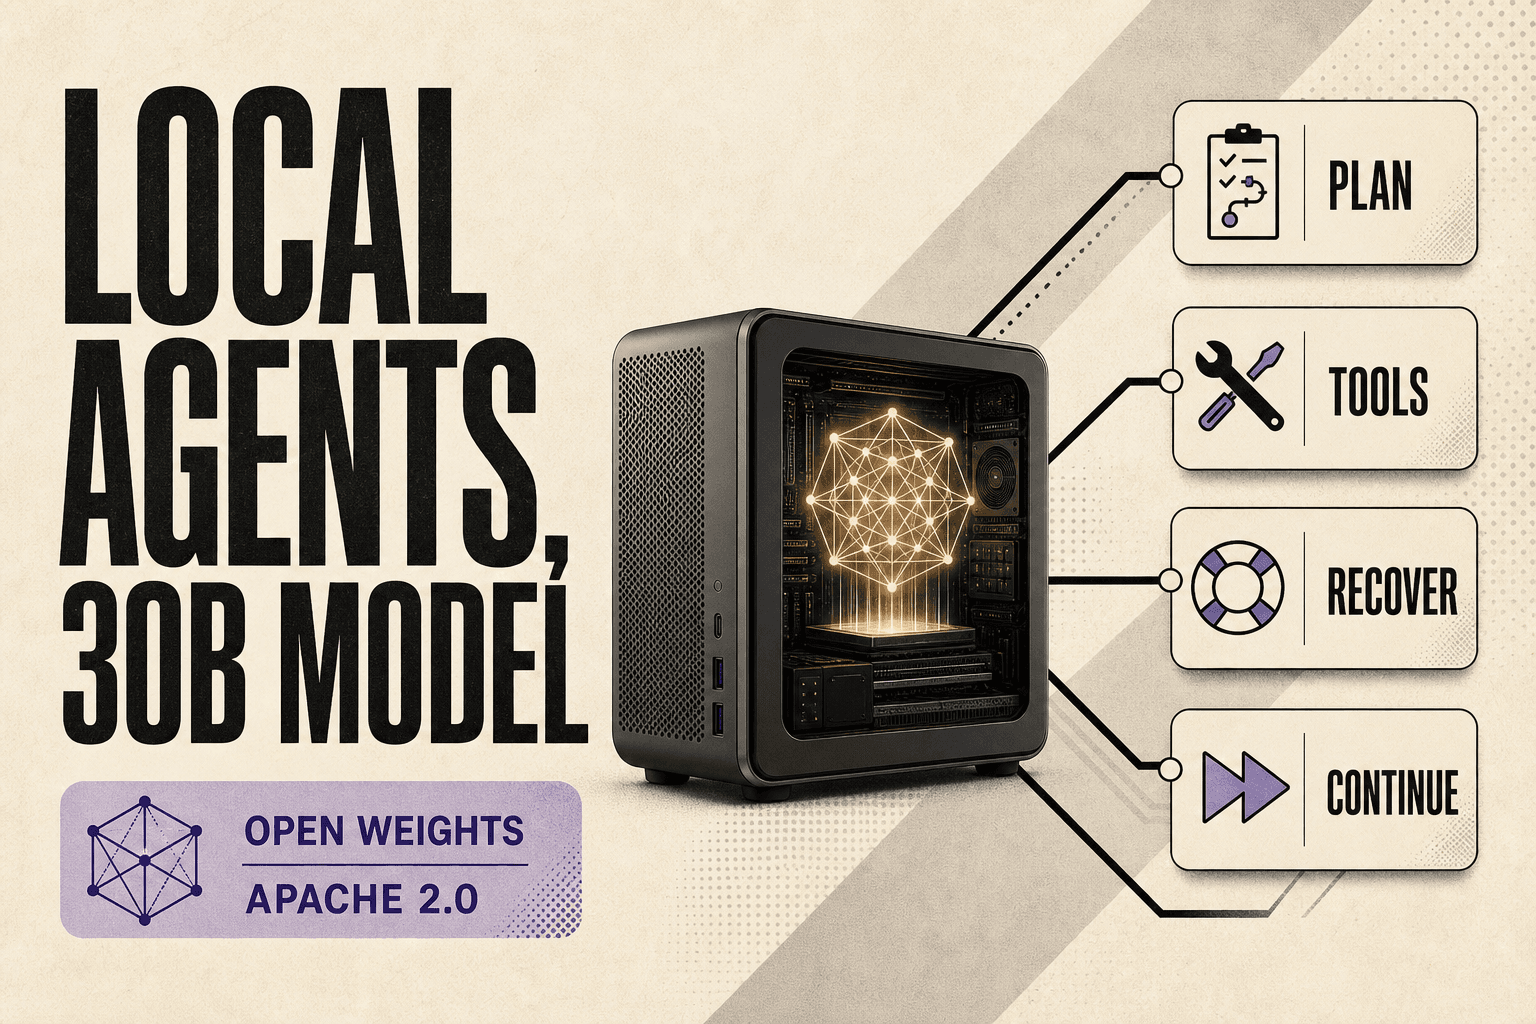
Meta и Unsloth представляют Muse Glimmer как мультимодальную open-weight модель примерно с 30 миллиардами параметров, лицензией Apache 2.0 и квантованными версиями для потребительского оборудования.
Интересен здесь не только размер модели. Muse Glimmer рассчитана на agentic workflows, в которых модель должна спланировать задачу, вызвать инструменты, обработать ошибку и продолжить работу с текущего состояния.
Что можно запускать локально?
Модель доступна в формате GGUF и других вариантах для локального запуска. Требования к памяти зависят от квантования, длины контекста, KV cache и распределения нагрузки между RAM и VRAM.
В руководстве Unsloth указаны разные конфигурации: примерно от 18 ГБ общей памяти до 24–32 ГБ и выше. Поэтому фраза “работает на 24 ГБ” не означает, что любая версия 30B будет одинаково работать на любой видеокарте с 24 ГБ.
Почему важен agent workflow
Вместо ответа на один запрос модель может участвовать в более длинном процессе: планировать, вызывать инструменты, проверять результат, менять направление и продолжать работу. Устойчивость такого процесса также зависит от harness, runtime-памяти и разрешений, которые получает агент.
Сравнение меняется: это уже не только выбор между сильной облачной моделью и более дешёвой локальной. Важно и то, насколько модель подходит для продолжительной работы над одной задачей.
Источники
Muse Glimmer 30B на Hugging Face и руководство Unsloth по локальному запуску.