צוות Qwen של Alibaba שחרר את Qwen3.8-Flash-Next — מודל MoE מולטימודלי עם משקלים פתוחים, שמשמש גם כתצוגה מקדימה מוקדמת של הארכיטקטורה שתעמוד בבסיס Qwen4.
המאפיינים המרכזיים
- 125 מיליארד פרמטרים במודל הראשי;
- 51 מיליארד פרמטרים נוספים של N-gram embeddings;
- כ-6 מיליארד פרמטרים פעילים בכל טוקן;
- הקשר טבעי של עד 256K טוקנים;
- תמיכה ב-coding agents, computer use וראייה.
הרעיון המרכזי הוא לא להפעיל את כל המודל עבור כל טוקן. רק חלק מהפרמטרים מופעל בכל רגע, בעוד שאר הקיבולת משמשת כידע מאוחסן נוסף.
מה השתנה בארכיטקטורה
Qwen משלבת את Gated DeltaNet, את Qwen Sparse Attention, את N-gram embeddings ואת Multi-Token Prediction. DeltaNet דוחסת את ההיסטוריה למצב קומפקטי, ו-Sparse Attention מחפשת מידע רלוונטי במיקרו-בלוקים במקום לסרוק כל טוקן.
N-gram embeddings מאפשרים שליפה מהירה של תבניות נפוצות. Multi-Token Prediction יכולה לשפר את מהירות היצירה באמצעות הצעה של כמה טוקנים לבדיקה.
תוצאות ומגבלות
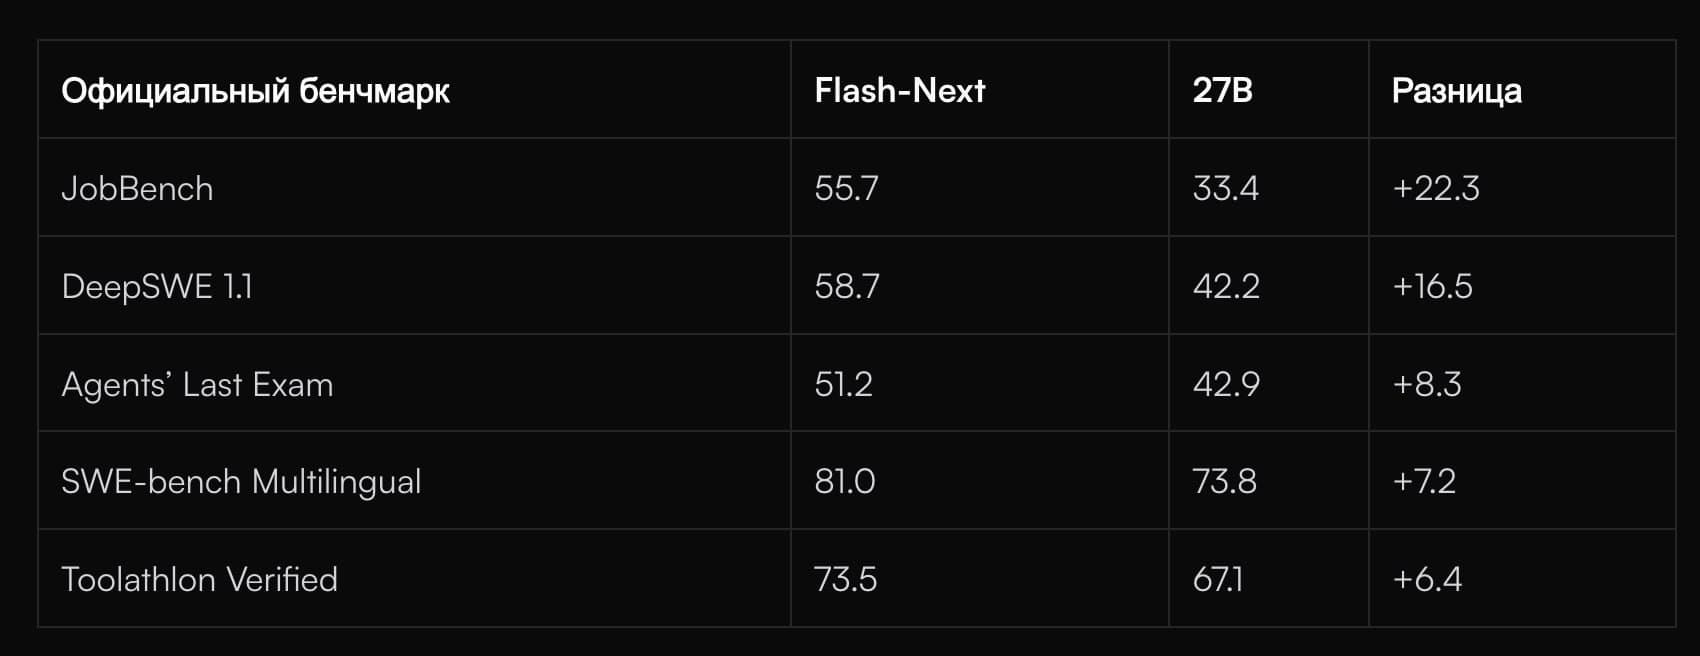
בבדיקות שפורסמו על ידי Qwen, Flash-Next השיגה תוצאות טובות יותר מ-Qwen3.8-27B בכמה משימות, כולל JobBench, DeepSWE 1.1 ו-SWE-bench Multilingual.
עם זאת, 6 מיליארד פרמטרים פעילים אינם אומרים שכל המודל נכנס לזיכרון כמו מודל 7B רגיל. ההרצה בפועל תלויה בקוונטיזציה, RAM, SSD, VRAM ובתמיכה של מנוע ההרצה.
הניסוח המדויק יותר הוא לא “125B שרץ כמו 7B”, אלא “מודל בעל קיבולת גדולה שמנסה לשמור על חישוב לכל טוקן הקרוב יותר למודלים קטנים”.
למה זה חשוב
Qwen3.8-Flash-Next מעניינת עבור coding agents, ניתוח מסמכים גדולים, עבודה עם מאגרי קוד ו-computer use. היא מצביעה על כיוון חדש ל-AI מקומי: לא רק להקטין מודלים, אלא להפעיל בכל רגע רק את הידע שנדרש.
מאגר רשמי: QwenLM/Qwen3.8-Flash-Next. Hugging Face: Qwen3.8-Flash-Next.