Команда Qwen от Alibaba выпустила Qwen3.8-Flash-Next — открытую мультимодальную MoE-модель, которая одновременно служит ранним превью архитектуры будущей Qwen4.
Главные характеристики
- 125 млрд параметров основной модели;
- 51 млрд параметров в N-gram embeddings;
- около 6 млрд активных параметров на токен;
- контекст до 256K токенов;
- поддержка coding agents, computer use и работы с изображениями.
Идея архитектуры — не запускать всю модель целиком при каждом токене. Активируется только часть параметров, а остальная ёмкость используется как дополнительная база знаний.
Что изменилось в архитектуре
Qwen сочетает Gated DeltaNet, Qwen Sparse Attention, N-gram embeddings и Multi-Token Prediction. Gated DeltaNet сжимает историю в компактное состояние, а Sparse Attention ищет нужную информацию по микроблокам, а не по каждому токену.
N-gram embeddings помогают быстро обрабатывать часто встречающиеся паттерны. Multi-Token Prediction может ускорять генерацию, заранее предлагая несколько следующих токенов для проверки.
Результаты
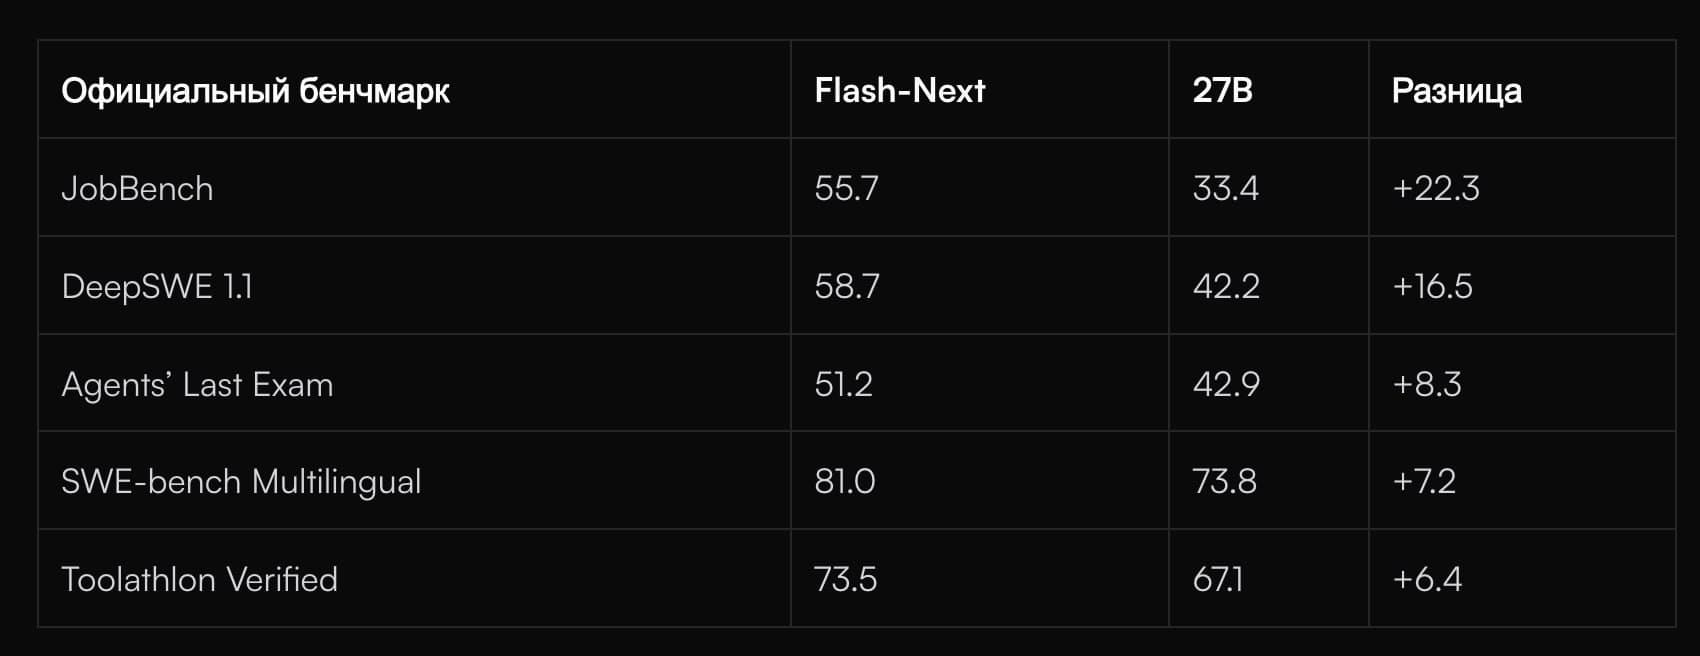
В опубликованных Qwen тестах Flash-Next показала более высокие результаты, чем Qwen3.8-27B, в ряде задач: JobBench — 55,7 против 33,4, DeepSWE 1.1 — 58,7 против 42,2, SWE-bench Multilingual — 81,0 против 73,8.
Главное ограничение
6 млрд активных параметров не означают, что вся модель помещается в память как обычная 7B-модель. Реальная конфигурация зависит от формата квантования, RAM, SSD, VRAM и поддержки конкретного движка.
Поэтому точнее говорить не «125B работает как 7B», а «модель большой ёмкости пытается сохранить вычислительную стоимость ближе к компактным моделям».
Почему это важно для локального AI
Qwen3.8-Flash-Next интересна для coding agents, анализа больших документов, работы с репозиториями и computer use. Модель показывает направление развития локального AI: не только уменьшать размер, но и активировать в каждый момент лишь ту часть знаний, которая действительно нужна.
Официальный репозиторий: QwenLM/Qwen3.8-Flash-Next. Модель на Hugging Face: Qwen3.8-Flash-Next.